商汤实测 GPT-6-Astra 并开源 SenseNova-RoboRSI:具身智能下一步怎么走?
一个机器人连续5次都没完成任务,你会判断它“不会做”吗?
商汤在测试 GPT-6-Astra 时,遇到了一个出乎意料的结果:RoboDojo 仿真评测中的9个任务,原本都是5次全失败。没有重新训练模型,只是允许它继续交互、把步数上限提高到原来的10倍,结果变成了5次全成功。
有些“不会做”,原来是我们太早按下了停止键。
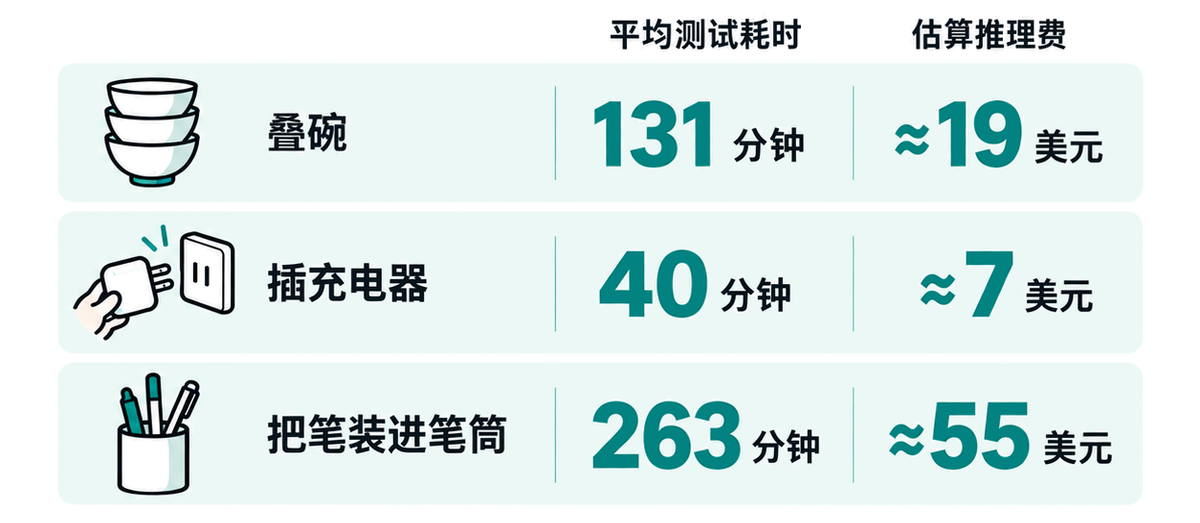
但如果一直等下去,代价又有多大?在扩展预算的测试中,叠碗的平均测试耗时约131分钟,估算推理费用约19美元;把笔装进笔筒平均耗时263分钟,估算推理费用约55美元。任务终于完成了,可这样的机器人,距离日常使用显然还有很长一段路。
更有意思的是,解决问题有时也不需要一直重试。在一次真机插花实验中,GPT-6-Astra 看不清瓶口,便移动空闲机械臂,用另一只手上的相机帮自己看清,随后完成插入。它把第二只手,变成了帮助自己完成任务的“眼睛”。
哪些失败值得多给一次机会?哪些困难需要换一种办法?又有哪些问题,即使模型足够聪明,也很难靠不断尝试解决?
商汤通过12个模拟评测、8款机器人的系统研究,尝试回答这些问题,并同步开源日日新 SenseNova-RoboRSI 框架与27B具身模型,将任务完成成本降至 GPT-6-Astra 的 1/50,并让社区能够复测这些发现,继续探索更高效的解决路径。
- 技术报告主页: https://www.sensenova.ai/has-gpt-6-astra-achieved-embodied-intelligence
- 技术报告:https://github.com/OpenSenseNova/SenseNova-RoboRSI/blob/main/assets/has_gpt-6_achieved_embodied_intelligence.pdf
- SenseNova-RoboRSI代码库: https://github.com/OpenSenseNova/SenseNova-RoboRSI
一、探索能力上限:有些失败,是停止得太早
在我们研究的 12 个模拟器榜单上,涵盖桌面机械臂、人型机器人、轮臂和灵巧手等任务形态,我们发现,只需解除两个限制,就能进一步探索 GPT-6-Astra 的能力上限:
- 第一,允许访问训练集,使GPT-6-Astra 可以先学习再实践(业内称之为 In-context Learning,简称 ICL)。
- 第二,解除步数限制,将可用步数最高提升至各个榜单官方设置的 10 倍。
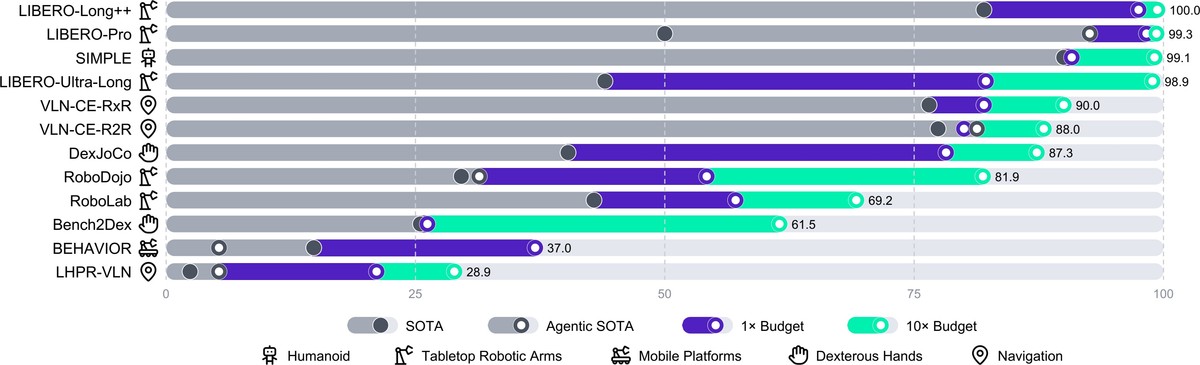
图 1 只需解除两个限制,GPT-6-Astra 的具身能力上限显著拔高
解除上述两个限制后,GPT-6-Astra 在多项评测中进一步逼近当前能力边界。在 LIBERO 系列(较为简单的桌面机械臂操作)和 SIMPLE(人型机器人执行移动和操作任务)上,其表现已经完全饱和;在近期受到关注的 RoboDojo 上任务成功率也达到 81.9%。
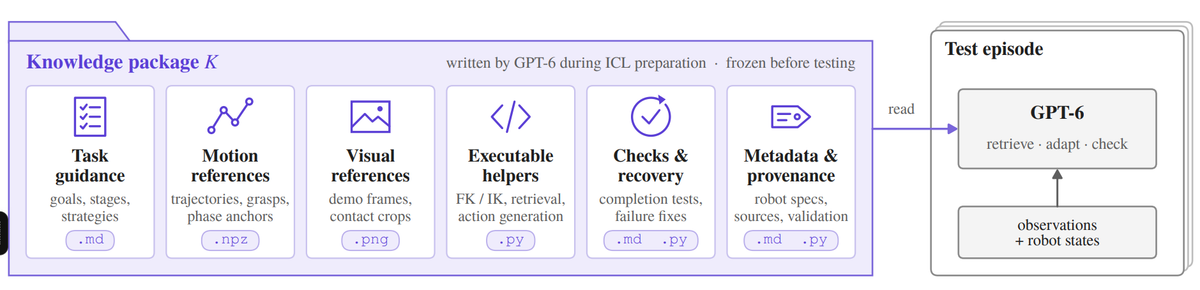
图 2 In-context Learning中,GPT-6-Astra 给自己准备了怎样的“小抄”?
ICL过程还揭示了模型是如何思考一个具身问题的。执行任务前,GPT-6-Astra 会研究训练示范中的图像、机器人状态和动作轨迹,并将有用信息整理成任务笔记、参考动作与代码工具;测试时,再结合现场观察调用和调整这些资料。通常,每个任务只需准备一次,之后便可用于该任务的多次测试。图 2 总结了在ICL过程中形成的六大能力。
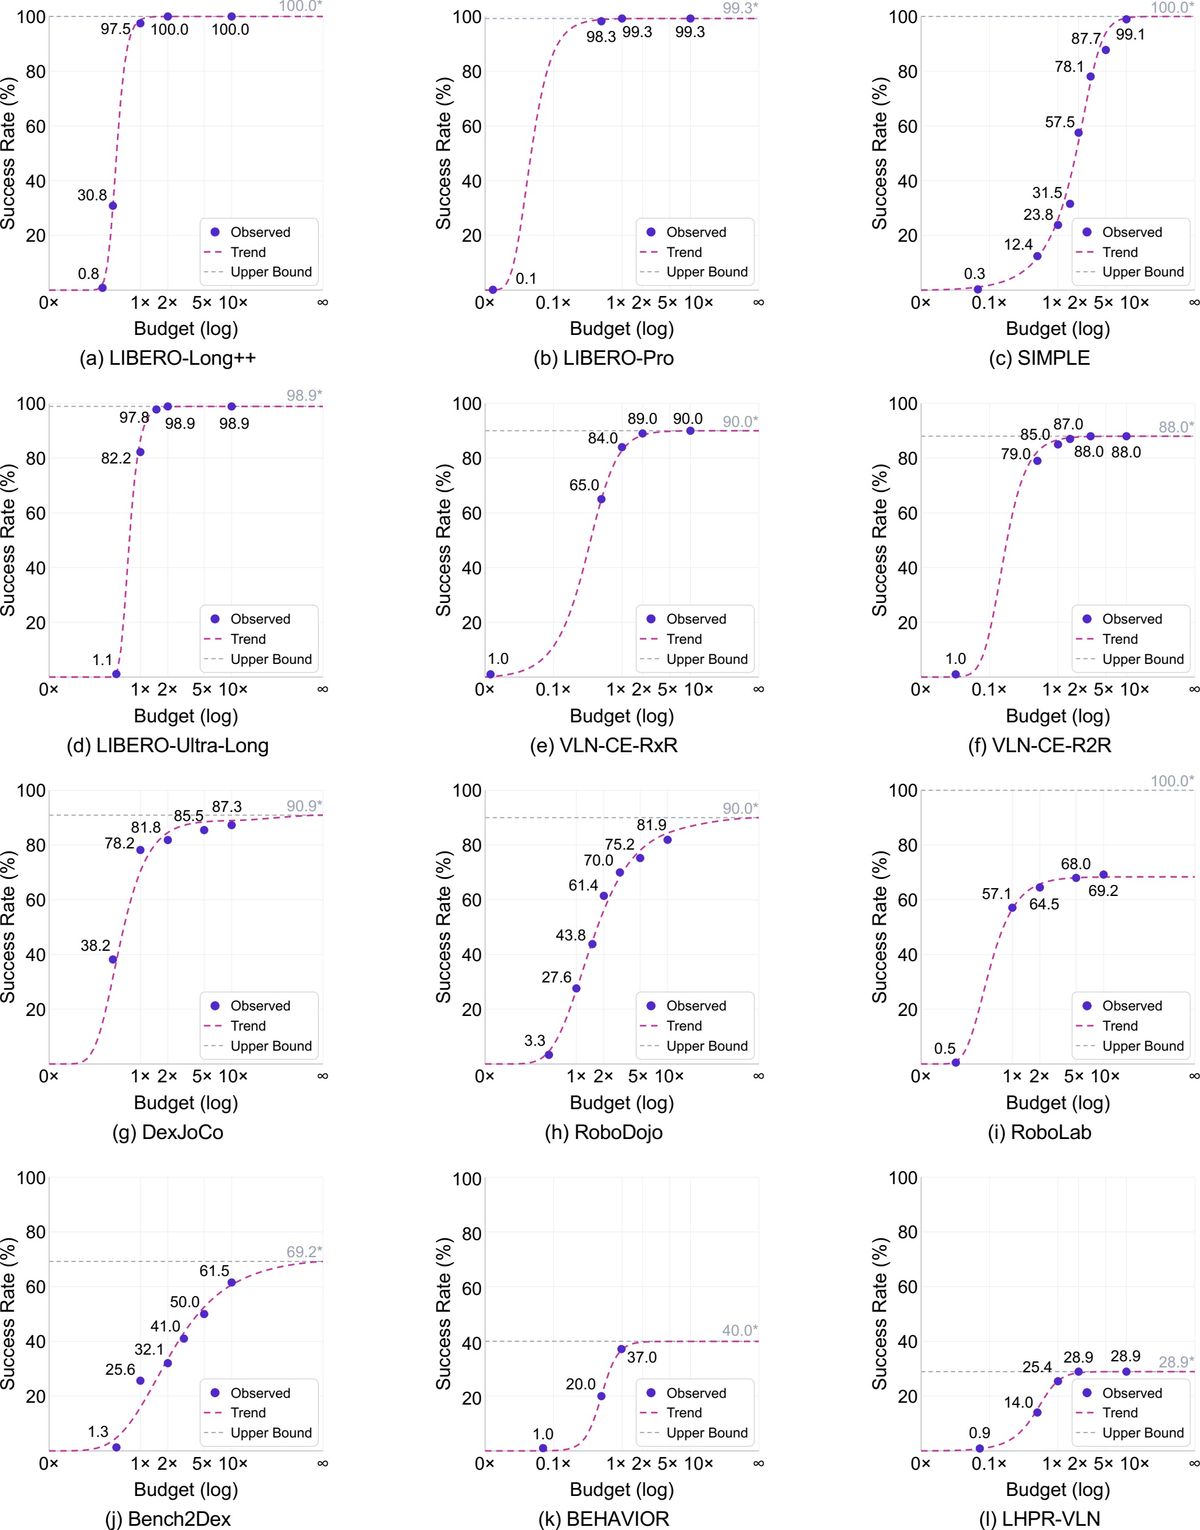
图 3 步数增长在各个榜单上展现出的表现提升以及对于无限步长的性能上限估计
图 3 展示了增加步数后各榜单的表现变化,以及对无限步长情况下性能上限的估计。在步数趋近无限的假设下,GPT-6-Astra 在大量榜单上已达到或接近性能饱和。这意味着,当前社区榜单在一定程度上已经被 GPT-6-Astra 推近甚至触及能力天花板;研究重点需要从单纯追求榜单成绩,进一步转向能力能否迁移、成本能否下降,以及任务能否在真实环境中可靠完成。
二、落地瓶颈:做得成,还要用得起
GPT-6-Astra 展现出的能力令人惊讶,但榜单成绩逼近上限,并不意味着具身智能已经解决落地问题。结合实验,我们发现,至少还有三类瓶颈需要突破。
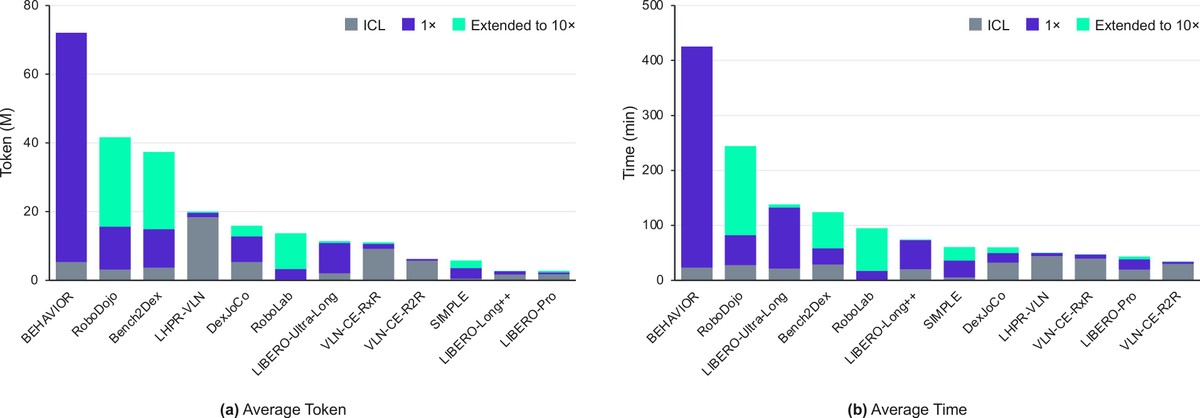
图 4 GPT-6-Astra 在各榜单上单任务平均的 Token 花销(简单换算可以认为 1M Tokens = 1 USD) 及时间消耗
- 第一,经验的跨任务迁移能力仍然有限。GPT-6-Astra 通过 ICL 获得的性能提升,仍高度依赖机器人本体的演示数据;从单个任务中形成的 ICL 技能包,在跨任务迁移方面还不够强。
- 第二,执行成本距离商业可行仍有多个数量级的差距。图 4 展示了各榜单的单任务平均 Token 开销和时间消耗。例如,完成“把笔装进笔筒”这一对人来说极其简单的任务,需要花费 263 分钟、55 美元。
- 第三,长序任务仍是明显短板。在 BEHAVIOR(大场景轮臂作业)和 LHPR-VLN(需要探索的长序视觉导航)上,GPT-6-Astra 的表现仍然最弱。
- 第四,任务执行的稳定性和鲁棒性仍需提升。我们还观察到模型在任务执行中存在具体问题:有时无法确认任务是否已经完成,有时无法妥善处理物理状态变化,也可能在多个子任务之间顾此失彼。这说明,具身系统不仅需要做出正确动作,还需要持续核验执行结果,并根据环境变化调整后续策略。
三、快慢协作,关键在闭环
因此,一个关键问题是:能否通过 Harness 系统,让 System 2 慢思考模型(GPT-6-Astra)与 System 1 快思考模型( 本文由方向对了资讯网发布,不代表方向对了资讯网立场,转载联系作者并注明出处:https://zhenyes.com/industry/9096.html